Luke Dev Notes
一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(上)
AI 程式開發工具會一直增加。當 Cursor、Claude Code、Codex、Antigravity 各自帶著一份規則檔進專案,幾個月後常會發現規則彼此已經說了不同的事。 我現在把專案當成穩定入口:共用規則放在 AGENTS.md,完整任務流程放在 .skills/,工具需要特定探索位置時只放輕量 adapter。工具換了,真正需要維護的內容仍然留在專案裡。更新(2026-08-24):本文已配合本專案的原生 skill 探索 adapter 更新。實作細節與 Antigravity、Cursor 的使用方式請接著閱讀 Part 2。1. 四個工具如何接到同一份專案規則 四個工具的入口不同,但它們都可以回到同一個原則:把跨工具、長期穩定的內容留在專案,讓工具專屬設定只處理載入方式。 Codex:AGENTS.md 是專案指引的指令鏈 Codex 在開始工作前會讀取 AGENTS.md。它會從專案根目錄一路走到目前工作目錄,逐層合併規則;較靠近工作目錄的 AGENTS.md 或 AGENTS.override.md 會排在後面,因此能覆寫前面的通用規則。 這很適合放全專案都要遵守的資訊:專案結構與常用指令 建置、型別檢查與測試規則 提交與審查的期待 共用 skills 的唯一來源如果 src/content/posts/ 有特別的工作限制,可以在那個資料夾新增較近的指引。全域規則仍然放在根目錄的 AGENTS.md,讓新進專案的 agent 一開始就知道基本工作方式。 Claude Code:用 CLAUDE.md 匯入同一份指引 Claude Code 的預設入口是 CLAUDE.md。既然專案的共用規則已經放在 AGENTS.md,CLAUDE.md 只需要保留官方匯入語法: @AGENTS.md這個檔案是 adapter,不承載另一份規則。指令、驗證方式與 Git 流程改動時,只修改 AGENTS.md,Claude Code 也會讀到同一個版本。 Antigravity:把共用規則放進可執行的任務脈絡 Antigravity 適合處理跨編輯器、終端機、瀏覽器的完整任務。對這個專案,我會在任務一開始要求 agent 讀 AGENTS.md,再依 skills 索引開啟命中的 .skills/<name>/SKILL.md。 例如文章更新可以直接交代: 更新中英文文章。先讀 AGENTS.md 與命中的 skill,完成後跑 skills:check、npm run check、npm run build。接著讓 agent 依序改內容、執行指令、啟動預覽;最後再從計畫、截圖或瀏覽紀錄檢查成果。這是任務執行層的安排,專案的流程本體仍然只有 .skills/ 那一份。 Cursor:共用規則用 AGENTS.md,路徑觸發用 .cursor/rules Cursor 可以把根目錄的 AGENTS.md 當成簡單的專案指引。這足以承接整個專案都適用的規則。 當某條規則只適用於一類檔案時,再加入 .cursor/rules/*.mdc。例如文章被開啟或修改時,讓規則檔只指向完整流程: --- description: Apply the blog writing workflow globs: src/content/posts/**/*.md alwaysApply: false ---Read and follow `.skills/tech-blog-polish/SKILL.md` before editing this post.這個 adapter 只回答「什麼時候載入」,不複製文章結構與語氣規則。Cursor 的檔案路徑能力保留下來,流程也不會分裂成多份。 2. 專案的最小共用策略 我會把規則拆成三個層次:AGENTS.md 放穩定指引,.skills/ 放完整任務流程,工具資料夾放產生的或依路徑套用的 adapters。這個分法讓每個檔案都有單一責任,也讓審查時能快速判斷一條規則該放在哪裡。 Luke-Tech-Blog/ ├── AGENTS.md # 專案指引 ├── CLAUDE.md # 匯入 AGENTS.md ├── .skills/ # 完整且唯一的流程 ├── .claude/skills/ # 產生的原生探索 adapter ├── .agents/skills/ # 產生的原生探索 adapter └── .cursor/rules/ # 可選的檔案路徑觸發規則AGENTS.md 的內容保持短而穩定: ## Repository Expectations- Keep the complete workflow only in `.skills/<skill-name>/SKILL.md`. - `.claude/skills/` and `.agents/skills/` are generated native-discovery adapters. - Run `npm run skills:sync` after changing skill frontmatter..skills/ 才放會反覆演進的細節,例如文章潤稿的讀者設定、段落結構與語氣,或 Git 審查的檢查順序與提交規則。 需要 Claude Code 與 Codex 的原生探索時,執行同步腳本產生 adapter: npm run skills:sync npm run skills:check前者更新產生檔,後者只驗證同步狀態。這讓失步變成可以在提交前或 CI 明確攔下來的錯誤。一份共用規則能走得久,前提是每個工具只帶走它需要的入口。結論:先讓規則收斂,再讓工具各自發揮 四個工具各有適合的使用方式:Codex 與 Claude Code 可直接接到共用指引;Antigravity 適合執行長任務並留下可檢查的成果;Cursor 適合按檔案路徑自動附加規則。 先把 AGENTS.md 與 .skills/ 定為唯一來源,後面的工具整合才不會變成持續複製文件的工作。 下一篇會回到這個部落格專案,實際展示 Claude Code 與 Codex 的原生探索 adapters,以及 Antigravity、Cursor 在同一份流程上的使用方式。一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(下)參考資料OpenAI Codex:Custom instructions with AGENTS.md Claude Code:How Claude remembers your project Cursor:Rules Google Antigravity:agentic development platform
Read More 一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(下)
上一篇先整理了官方文件的共同方向:AGENTS.md 可以成為專案的共用指引。這一篇回到我自己的部落格專案,說明我如何讓 Claude Code 與 Codex 直接發現同一組 skills。一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(上)更新(2026-08-24):這個專案已加入可提交的原生探索 adapters。.skills/ 仍是唯一完整流程,.claude/skills/ 和 .agents/skills/ 只保留產生出的入口。我的目標很明確:專案指引只維護一份 任務流程只維護一份 工具專屬檔案只做 adapter 團隊共用的內容進 Git這樣換工具時不用重寫規則。接下來我把實作分成兩段:先處理 Claude Code 與 Codex 的原生探索,再補上 Antigravity 與 Cursor 該怎麼接到同一份專案規則。 1. Claude Code 與 Codex:一份流程,多個原生入口 上一版架構已經讓 agent 可以從 AGENTS.md 找到 .skills/。實際使用時,工具開啟專案後若能直接掃描自己的 skills 目錄,任務發現會更自然;我不必在每個指令裡重複提醒「先去 .skills/ 找流程」。 這次完成後的結構如下: Luke-Tech-Blog/ ├── AGENTS.md ├── CLAUDE.md ├── .skills/ │ ├── README.md │ ├── tech-blog-polish/ │ │ └── SKILL.md │ ├── git-change-commit-review/ │ │ └── SKILL.md │ └── linkedin-blog-promo/ │ └── SKILL.md ├── .claude/ │ └── skills/ │ ├── tech-blog-polish/ │ │ └── SKILL.md │ ├── git-change-commit-review/ │ │ └── SKILL.md │ └── linkedin-blog-promo/ │ └── SKILL.md ├── .agents/ │ └── skills/ │ ├── tech-blog-polish/ │ │ └── SKILL.md │ ├── git-change-commit-review/ │ │ └── SKILL.md │ └── linkedin-blog-promo/ │ └── SKILL.md └── scripts/ └── sync-skills.mjsAGENTS.md 依然是專案指引的入口,放常用指令、驗證方式、專案結構與 Git 流程。CLAUDE.md 仍然只匯入它: @AGENTS.md真正的任務流程放在 .skills/<skill-name>/SKILL.md。兩個工具目錄裡的同名檔案則是 adapter,讓 Claude Code 與 Codex 可以用各自的原生探索找到同一個 skill。 完整流程只寫一次 adapter 的內容刻意很短。以 tech-blog-polish 為例,產生出的檔案只保留 skill 的 frontmatter,以及導向唯一來源的指示: --- name: tech-blog-polish description: Polish technical blog articles for this project... ---# Canonical Skill完整流程在 `.skills/tech-blog-polish/SKILL.md`。先讀該檔,再依其步驟執行。這個設計刻意避開把完整內容複製三份。文章潤稿規則、Git 審查規則,甚至未來新增的流程,都只修改 .skills/ 內的 SKILL.md。 AGENTS.md 也明確說出這個責任分工: Keep the complete workflow only in `.skills/<skill-name>/SKILL.md`. `.claude/skills/` and `.agents/skills/` are generated native-discovery adapters..skills/ 是完整流程的唯一來源;原生 adapter 只負責讓工具找到它。用腳本產生 adapter,讓失步變成可檢查的錯誤 Windows symlink 在不同開發環境仍可能遇到權限差異。因此這個專案用 Node.js 小腳本 scripts/sync-skills.mjs 產生檔案,而非依賴 symlink。 它會逐一讀取 .skills/ 的子目錄,確認 SKILL.md 有 name 與 description frontmatter,再把精簡 adapter 寫到兩個原生探索位置: .skills/<name>/SKILL.md ├─> .claude/skills/<name>/SKILL.md └─> .agents/skills/<name>/SKILL.md日常修改後跑: npm run skills:syncCI 或提交前則跑: npm run skills:check--check 不會寫檔。只要唯一來源的 skill frontmatter 或 adapter 內容沒有同步,它就會列出需要更新的檔案並以失敗結束。這讓「有人改了 .skills/ 卻忘了更新 adapter」成為明確、可重現的問題。 2. 補充:Antigravity 與 Cursor 的使用方法 這兩個工具不需要複製另一份 skill。它們適合補上不同層次的工作方式:Antigravity 處理跨編輯器、終端機、瀏覽器的任務執行;Cursor 處理與特定檔案路徑綁定的即時規則。 Antigravity:從 AGENTS.md 進入,交給 agent 完成整段任務 在 Antigravity 開啟這個專案時,我會先讓 agent 讀根目錄的 AGENTS.md。裡面的 skills 索引會指向 .skills/;任務命中後,agent 再讀對應的唯一來源 SKILL.md。這個順序讓專案指引、任務流程與工具操作各自有清楚的位置。 例如要更新一篇文章,我會直接交代任務範圍與驗證要求: 更新中英文 Part 2,先讀 AGENTS.md 與命中的 skill,完成後跑 skills:check、npm run check、npm run build。Antigravity 的 Manager Surface 適合這類需要編輯、跑指令與看預覽的長任務。完成後我會從它產生的計畫、截圖或瀏覽紀錄檢查結果,再決定是否送出下一輪修正。專案裡的 .skills/ 不需要為它另開副本。 Cursor:把檔案路徑觸發留給 .cursor/rules Cursor 也能讀根目錄的 AGENTS.md,因此全專案的規則仍然只有一份。當需求和檔案位置有直接關係時,才在 .cursor/rules/ 放一個短 adapter。例如文章被開啟或修改時,讓 Cursor 載入文章潤稿流程: --- description: Apply the blog writing workflow globs: src/content/posts/**/*.md alwaysApply: false ---Read and follow `.skills/tech-blog-polish/SKILL.md` before editing this post.英文文章可以用另一個相同概念的 rule,將 globs 指到 src/content/posts-en/**/*.md。這個 .mdc 檔只負責觸發,不重述文章結構、語氣與驗收細節;完整規則仍然在 .skills/tech-blog-polish/SKILL.md。 這樣分工後,Cursor 的自動附加規則解決「何時載入」,Antigravity 的 agent 任務解決「如何執行整段工作」,而 Claude Code 與 Codex 透過原生 adapters 解決「怎麼發現 skill」。四個工具都回到同一份流程。 結論:讓工具找到規則,也讓團隊只維護一份規則 AI 程式開發工具還會繼續變,skills 探索的目錄也可能不同。把流程直接複製到每個工具資料夾,長期一定會增加維護成本。 現在這個專案讓 .skills/ 承擔完整內容,腳本產生 Claude Code 與 Codex 的原生 adapters,再用 skills:check 守住同步。新工具要加入時,我只需要新增一個輕量 adapter,不必搬動整套流程。原生探索可以因工具而異;團隊共用的流程應該只有一個來源。參考資料OpenAI Codex:Agent Skills Anthropic:Agent Skills Cursor:Rules Google Antigravity:Agent 導向開發平台
Read More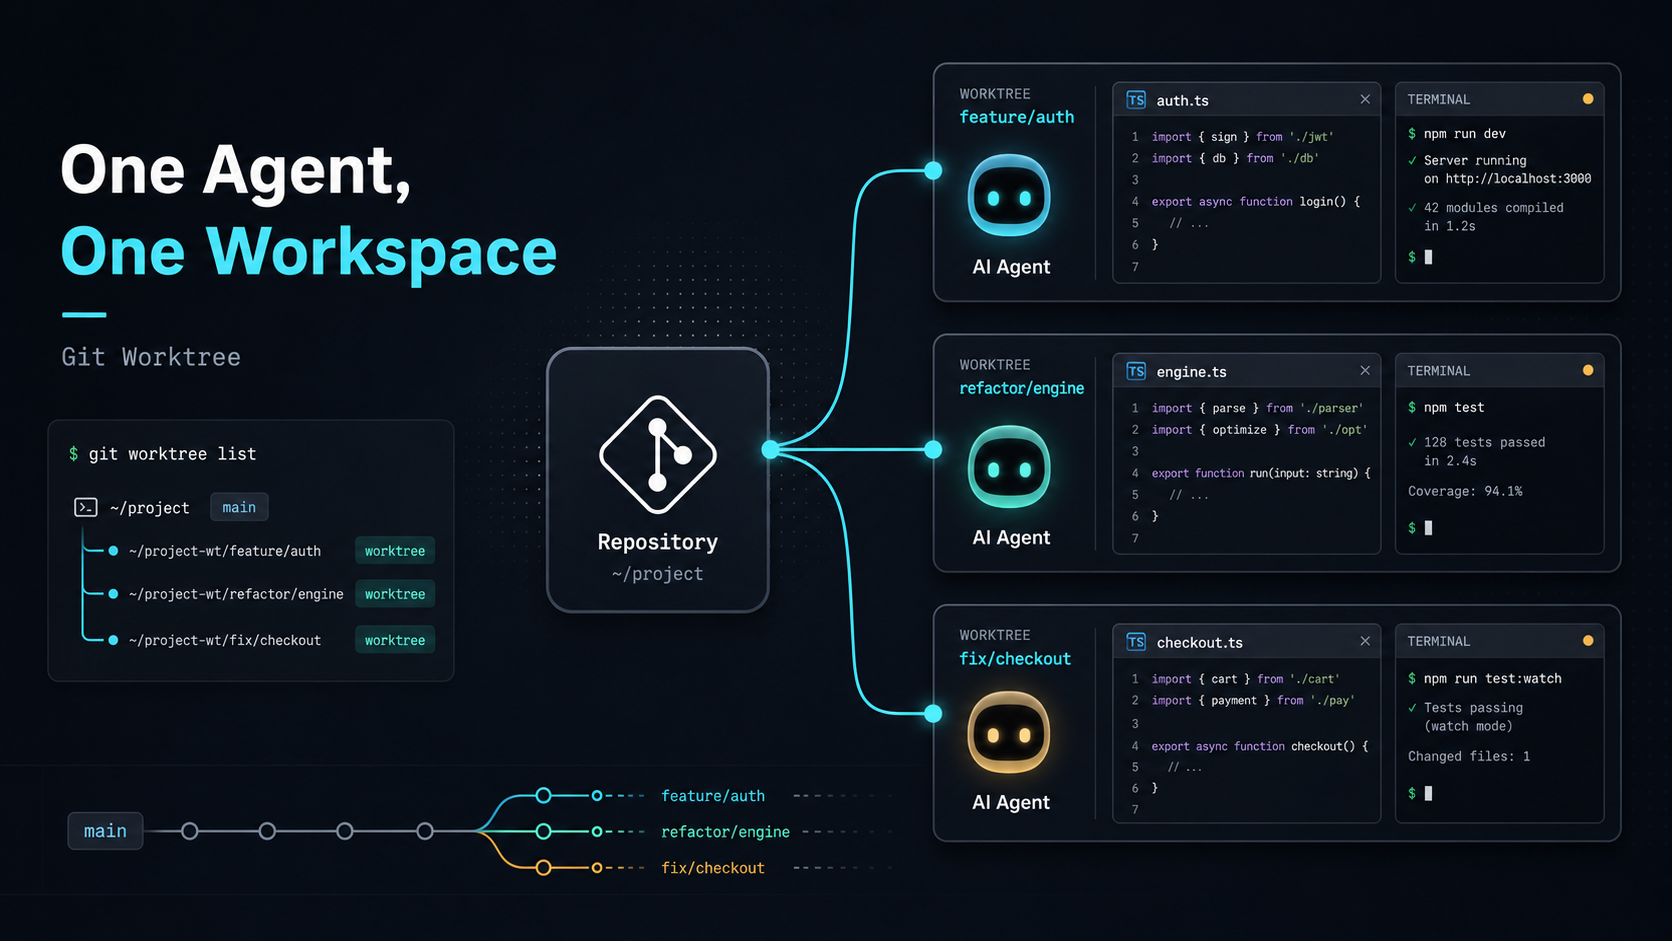
善用 AI Coding Agent(上):當 Branch 不足以支撐多 Agent 協作
AI Coding Agent 已經不只是「幫忙補程式碼」的工具。 我自己也付費使用多個 AI Coding 工具,包含 Cursor、Anthropic Claude Code、OpenAI Codex。這些工具的介面不同,但能力越來越接近:它們可以讀專案、改檔案、跑測試、修錯,甚至花一段時間完成一個比較完整的任務。 這讓我的使用方式開始改變。以前我把 AI 放在 IDE 裡,像一個隨叫隨到的助手;後來我開始把 Agent 當成可以接任務的人。這個轉變聽起來很小,實際上會改變整個工作流程。當 Agent 可以長時間工作,我們要管理的不只指令,也包含它正在使用哪一份專案檔案。這篇是「善用 AI Coding Agent」系列的上篇。我想先記錄一個實際遇到的問題:當我開始讓 Agent 跑長時間任務,原本靠 Git branch 切換的做法很快就不夠用了。 從局部修改開始 我一開始跟 AI 協作的方式,和很多開發者差不多:在 IDE 裡圈選一段程式碼,然後請 AI 幫我做局部修改。 例如:幫我重構這個 function 幫我補上 TypeScript 型別 幫我解釋這段邏輯 幫我把這個 API call 改成另一種寫法 幫我補測試這種方式非常直覺,也很有效。因為操作單位很小,風險也相對容易控制。AI 改完之後,我看一下 diff,覺得可以就接受,不行就退掉。 這個階段的工作方式很單純:我知道現在要改哪裡,AI 只負責處理我指定的那一小塊。它像是加速器,幫我把手上的工作做快一點。 當任務只有幾分鐘,這樣非常夠用。專案目前在哪個狀態、改了哪些檔案、要不要接受修改,都還在我的掌控範圍內。 長時間任務改變了問題 後來我在做 Prompt Engineering 相關工作時,遇到一類很適合交給 Agent 的任務:長時間評估。 例如:跑一批 prompt 評估案例 比較不同 prompt 版本的輸出品質 調整 evaluator 或 LLM-as-a-judge 的判斷邏輯 根據測試結果反覆修改 prompt 整理 trace 或測試報告這類任務通常不會改一個地方就結束。Agent 需要讀專案、跑指令、看結果、修改檔案,再重新驗證。時間可能從幾分鐘拉長到半小時甚至更久。 問題出現在等待期間。當一個 Agent 正在跑 prompt evaluation,我自己還想繼續開發新功能,或再開另一個 Agent 去修 bug。 當時我的想法很直接:能不能讓一個 Agent 在背景處理長時間任務,同時我繼續在另一個分支上開發?直覺答案是開新 branch。 Branch 看起來可以解決 我一開始也是這樣做的。 假設現在有一個主要專案資料夾: luke-tech-blog/我可以為長時間任務開一個 branch: git checkout -b agent/prompt-eval然後讓 Agent 在這個 branch 上執行 prompt 評估。 如果你不熟 Git,可以先把 branch 想成「同一個專案的不同版本路線」。一條路線用來做 prompt 評估,另一條路線用來開發新功能,聽起來很合理。 接著我想繼續開發新的搜尋頁面: git checkout -b feature/search-page這個瞬間,問題才真的浮出來。 同一個專案資料夾,一次只能顯示一個 branch 的檔案。當我從 agent/prompt-eval 切到 feature/search-page,目前資料夾裡的檔案也會跟著換成另一個版本。 這代表正在執行長時間任務的 Agent,看到的專案檔案被我換掉了。 對人類來說,這件事很好理解:我剛剛切了 branch,所以檔案換了。對正在工作的 Agent 來說,它只知道目前資料夾裡的檔案突然變了。它剛剛讀過的內容、跑過的測試、接下來準備修改的檔案,都可能和新的狀態對不上。 可以把它想像成同一張辦公桌上有兩個人在工作。Agent A 正在整理一份報告,我突然把整張桌子的文件換成另一個專案。Agent A 沒有離開,但它眼前的東西已經不是剛剛那一份了。Branch 可以分開專案的不同版本路線,但沒有替每個 Agent 準備自己的工作桌。問題其實在工作空間 這次經驗讓我重新理解問題。 我需要的結構是:同一個專案 不同 branch 不同資料夾 每個資料夾可以同時存在 我切換其中一個資料夾時,不影響另一個 Agent理想上,我希望專案可以長這樣: luke-tech-blog/ mainluke-tech-blog.prompt-eval/ agent/prompt-evalluke-tech-blog.search-page/ feature/search-page這樣我就可以把不同任務分配到不同目錄: Agent A -> luke-tech-blog.prompt-eval Agent B -> luke-tech-blog.search-page每個 Agent 都有自己的 branch,也有自己的資料夾。長時間任務不會因為我切 branch 被中斷,不同 Agent 的修改也不會混在同一個地方。 這是多 Agent 協作第一個很務實的限制:任務可以平行,工作空間也要能平行。 下一篇,我會接著介紹我後來改用的解法:Git worktree。它可以讓同一個專案在不同資料夾同時打開不同 branch,也讓每個 Agent 有自己的工作桌。 小結當 Agent 開始承接長時間任務,每個 Agent 都需要一個不會被別人突然換掉的工作資料夾。善用 AI Coding Agent(下):用 Git Worktree 替每個 Agent 建立獨立工作區
Read More 善用 AI Coding Agent(下):用 Git Worktree 替每個 Agent 建立獨立工作區
上一篇提到,我一開始想用 branch 解決多 Agent 協作的問題,後來發現單一 working directory 會把所有人綁在同一個 checkout 狀態上。善用 AI Coding Agent(上):當 Branch 不足以支撐多 Agent 協作當一個 Agent 正在某個 branch 上跑長時間任務時,如果我在同一個資料夾切到另一個 branch,Agent 實際看到的檔案也會跟著改變。這會讓它的上下文、測試結果、接下來要修改的檔案互相對不上。 我後來採用的解法是 Git worktree。它剛好提供我要的結構:同一個 repo,可以在不同資料夾同時打開不同 branch。Worktree 把 branch 從單一 checkout 狀態中拆出來,讓每個 Agent 都有自己的檔案現場。Worktree 的模型 Git worktree 可以讓同一個 Git repository 擁有多個 working tree。 簡單說,它可以替不同 branch 建立不同的工作目錄。 它不是重新 clone 一份 repository。這些 worktree 仍然共享同一份 Git 物件資料庫,但每個 worktree 都有自己的檔案目錄與 checkout 狀態。 用白話說: project/ mainproject.prompt-eval/ agent/prompt-evalproject.search-page/ feature/search-page每個目錄都有自己的 checkout 狀態。你在 project.search-page 修改檔案,不會改到 project.prompt-eval 的 working directory。 從成本角度看,worktree 不是免費的。每個 worktree 都會有一份實際檔案,空間複雜度可以粗略視為 O(s),s 是 working tree 展開後的檔案大小。它共享 Git object database,所以通常比完整 clone 省,但 node_modules、build cache、.env、產物目錄仍然各自存在。 建立或切換 worktree 的時間成本主要來自 checkout 檔案,粗略是 O(n),n 是需要寫入工作目錄的檔案數。實務上,這筆成本換來的是更穩定的隔離邊界:長時間任務不會被另一個 branch checkout 打斷。 建立 Agent 專用工作區 假設我現在在主專案目錄: cd luke-tech-blog我想替 prompt evaluation 任務建立一個新的 branch 和工作目錄,可以執行: git worktree add ../luke-tech-blog.prompt-eval -b agent/prompt-eval這個指令做了兩件事:建立一個新的 branch:agent/prompt-eval 建立一個新的工作目錄:../luke-tech-blog.prompt-eval接著我就可以進入那個目錄: cd ../luke-tech-blog.prompt-eval從這一刻開始,這個資料夾就是 agent/prompt-eval branch 的工作空間。 原本的 luke-tech-blog 目錄仍然可以停在 main 或其他 branch,不會被這個任務影響。 如果 branch 已經存在,只是想替它建立一個工作目錄,可以這樣做: git worktree add ../luke-tech-blog.search-page feature/search-page這會把 feature/search-page checkout 到 ../luke-tech-blog.search-page。 之後你就可以讓另一個 Agent 在這個資料夾工作。 管理 Worktree 可以用這個指令查看目前 repository 連到哪些 worktree: git worktree list輸出大概會像這樣: /Users/luke/projects/luke-tech-blog abc1234 [main] /Users/luke/projects/luke-tech-blog.prompt-eval def5678 [agent/prompt-eval] /Users/luke/projects/luke-tech-blog.search-page 789abcd [feature/search-page]任務完成、branch merge 之後,可以移除 worktree: git worktree remove ../luke-tech-blog.prompt-eval如果手動刪掉資料夾,Git 可能還保留著 worktree 紀錄。這時可以執行: git worktree prune這會清掉已經不存在的 worktree 紀錄。 指令小結日常使用先記住三個指令就夠:git worktree add、git worktree list、git worktree remove。我的多 Agent 分配方式 使用 Git worktree 之後,我的多 Agent 工作流會變成這樣: git worktree add ../project.prompt-eval -b agent/prompt-eval git worktree add ../project.search-page -b agent/search-page git worktree add ../project.refactor-card -b agent/refactor-card然後我會把任務講清楚: 你在 ../project.prompt-eval 這個 worktree 工作。 請專注處理 prompt evaluation 任務。 不要修改 UI、部署設定或無關的資料結構。 完成後請回報修改檔案、測試結果與風險。另一個 Agent 則可能是: 你在 ../project.search-page 這個 worktree 工作。 請實作搜尋頁面的前端功能。 不要修改 prompt evaluation 相關檔案。 完成後請執行 build,並整理主要 diff。這裡要建立的是一個可重複的工作流:一個 Agent 對應一個明確任務 一個任務對應一個 branch 一個 branch 對應一個 worktree 每個 worktree 有自己的檔案狀態這個規則可以降低 review 成本。每個 worktree 最後對應一組 diff,工程師可以用一般 Git 流程看變更、跑測試、決定 merge 順序。 它解決的痛點 Git worktree 最直接解決的是檔案工作區被互相影響的問題。 在單一資料夾裡,切 branch 會改變整個 working directory。你、Agent A、Agent B 共用同一個檔案現場;只要其中一方切 branch,其他工作都會受影響。 使用 worktree 之後,每個 Agent 都有自己的桌子: project/ mainproject.prompt-eval/ agent/prompt-evalproject.search-page/ agent/search-pageproject.refactor-card/ agent/refactor-card這帶來幾個好處:長時間任務不會因為你切 branch 被中斷 不同 Agent 的修改不會混在同一個 working directory 每個任務的 diff 更容易 review 可以保留一個乾淨的主工作區 多個 Agent 才真的有機會平行工作工作流小結Worktree 不會讓 merge conflict 消失,但它會讓每個 Agent 在任務執行期間擁有穩定的檔案世界。人類負責協調邊界 AI Coding Agent 變強之後,人類的工作開始往協調者靠近。 我現在更常做這些事:定義任務邊界 選擇適合交給 Agent 的工作 分配不同 worktree 限制修改範圍 要求 Agent 執行驗證 Review diff 決定哪些變更可以 mergeGit worktree 的價值就在這裡。它提供工程流程需要的隔離邊界,讓多個 Agent 可以同時工作,也讓人類保留 review、驗證、整合的控制權。 常見注意事項 使用 worktree 時,有幾個地方要注意。 第一,同一個 branch 通常不能同時被兩個 worktree checkout。這是 Git 的保護機制,避免同一條工作線在兩個地方同時被修改。 第二,不要直接把 worktree 建在原本 repo 的子目錄裡。否則有些工具在搜尋、格式化、跑測試時,可能會把其他 worktree 也掃進去。 我會比較建議這種結構: projects/ luke-tech-blog/ luke-tech-blog.prompt-eval/ luke-tech-blog.search-page/ luke-tech-blog.refactor-card/第三,多個 worktree 可能各自需要安裝 dependencies。即使它們共享 Git 物件,工作目錄裡的 node_modules、build cache、.env 等檔案仍然要自己管理。 這裡推薦一個實戰細節:如果你的專案使用 pnpm(非常適合 Astro 專案),因為其獨特的「全域硬體連結儲存庫(Global Hard-Link Store)」設計,在每個 worktree 目錄執行 pnpm install 不僅能秒級完成,而且幾乎不額外佔用磁碟空間。這能完美解決多 worktree 重複安裝套件又慢又佔空間的痛點。 此外,為了避免在桌面開啟多個 Cursor 或 VS Code 視窗造成的混亂,你可以使用 VS Code 的 Multi-root Workspace 功能。在根目錄建立一個 .code-workspace 檔案,同時引入主目錄與多個活躍的 worktree: { "folders": [ { "path": "luke-tech-blog" }, { "path": "../luke-tech-blog.prompt-eval" }, { "path": "../luke-tech-blog.search-page" } ] }這樣一來,你就可以在同一個 Cursor 視窗的側邊欄中,同時管理與檢視不同工作區的檔案與變更,協調邊界與審查 diff 都會變得極度輕鬆。 第四,worktree 只能隔離工作空間,不能消除 merge conflict。 如果兩個 Agent 同時修改同一個核心檔案,最後合併時還是可能衝突。Worktree 能避免工作期間互相踩檔案狀態,任務邊界仍然要由人類先設計好。 我會優先把這些任務分到不同 worktree:長時間評估任務 不同 feature 的開發 bug fix 文件更新 測試補強 UI 與 backend 可以明確分開的修改 refactor 範圍清楚的小型重構我會避免同時平行丟出這些任務:多個 Agent 同時重構同一個核心 abstraction 多個 Agent 同時修改 shared schema 多個 Agent 同時調整全域設定 任務描述只有「幫我優化整個專案」小結 當 AI Coding Agent 只幫我們改一小段程式碼時,單一 IDE、單一工作目錄通常就夠了。當 Agent 開始執行長時間任務,甚至多個 Agent 同時處理不同 feature,工作空間管理會變成第一個要補上的工程環節。 Git worktree 提供了一個很實用的基礎。每個 Agent 有自己的 branch 與資料夾,不同任務在檔案層級被隔離;人類負責定義任務、檢查結果、整合變更。 結論善用 AI Coding Agent 的第一步,是替每個長時間任務安排穩定、可驗證、可回收的工作空間。
Read More
PostgreSQL 效能優化(上):LIKE 和 Regex,哪個比較快?
這篇文章是我在工作上真的卡住過的一次效能問題。中間繞了一些路,最後才把真正的瓶頸抓出來。 本篇為上集,先談 LIKE 與 Regex 的抉擇與 I/O/CPU 迷思;接續兩集分別深入:中集:用 EXPLAIN 看見 Seq Scan 的真相 下集:用 Array + GIN 把標籤變成索引上集:當 LIKE 遇上 Regex,到底差在哪? 1. 問題背景(白話版) 我在工作上接了一批 ETL 後的資料。每筆資料裡,很多標籤被塞在同一個欄位,用 ; 串起來,像這樣: tag1;tag2;tag3;tag_VIP;tag_inactive 當我要找特定標籤時,最直覺是寫很多個 LIKE。 2. 同事一句提醒,直接點到問題 同事說:「把多個 LIKE 合成一個 Regex,通常會更快。」 我第一反應是:「沒有索引的話,不是都要整張表一筆一筆看過去嗎?那真的會快多少?」 3. 我們都沒錯,只是看的是不同成本 後來我才搞懂,我們其實切入點不同:我先看讀取成本(I/O),同事先看運算成本(CPU)。我看的是 I/O(讀資料成本)沒有索引時,資料庫通常還是要掃很多資料。這件事不會因為你改成 Regex 就消失。 同事看的是 CPU(運算成本)多個 LIKE 代表同一列要重複比對很多次;合成一個 Regex,通常可把「重複比對」變少。用比喻來說:多個 LIKE 像是同一本書翻很多輪,每次找一個關鍵字。 單一 Regex 像是一輪閱讀就把多個關鍵字一起判斷。4. 這篇上集我最想說的事 如果資料量還小,Regex 可能已經很有感。但資料一大,只換語法通常不夠,最後還是得讓資料庫用不同方式找資料。 結論Regex 可以先減輕 CPU 壓力,但只要查詢還在掃整張表,I/O 依然會是主瓶頸。中集從 EXPLAIN ANALYZE 拆解 LIKE 與 Regex 的真實成本,下集則動手實作 Array + GIN:PostgreSQL 效能優化(中):用 EXPLAIN 看見 Seq Scan 的真相 PostgreSQL 效能優化(下):用 Array + GIN 把標籤變成索引
Read More