
Luke Kong
專精 Agentic AI Workflow、Multi-Agent(LangChain / LangGraph)、流程自動化(n8n、FastAPI)與 RAG / Text-to-SQL。持有 Azure AI Engineer 與 AWS 雲端架構師認證,專注將商業邏輯轉為可上線的 AI 與自動化系統,並以 LLM-as-a-judge 與 trace 分析確保 production 穩定度。
Posts by Luke Kong
導入 AI:從改善既有工作,到重新設計工作方式
做了 HR 知識助手和 GenBI,然後呢? 我做過不少 AI Agent 和 Workflow,包含 HR 知識助手與 GenBI。 HR 知識助手用 RAG,從人資文件裡找資料來回答問題。GenBI 則用 Text2SQL,讓不會寫 SQL 的人,也能用日常語言自己查資料。 做這些助手,目的很直接:少花一點時間找資料,少一點重複工作。但做著做著,我也開始想,資料查出來之後呢? 像 GenBI,使用者可能拿數據整理報表,再交給主管;也可能繼續追問,往下探索。前者讓原本的工作更快完成,後者則有機會讓人問出以前因為不會查資料,而沒有繼續問下去的問題。 這也呼應我在企業裡看到的兩種期待:有人想讓 AI 接手自己不想做的事,有人想試試以前成本太高、做不到的事。這兩種期待會出現在同一個工具裡。 自動化早就有了,n8n 和 RPA 都能處理不少重複作業。AI 加進來之後,我更在意它能讓使用者多做到什麼。 以我自己的經驗來說,用 AI 省下時間後,我並沒有因此做更多工作。如果用完成的工作量來看,生產力並沒有增加多少,最直接的好處就是省下時間。這也讓我想繼續看,這些改變有沒有讓團隊多完成什麼。 員工交得快,主管還是只有一個 大人學 EP715 談到一個情境:員工用 AI 省下了幾天工時,提案交出去,卻還要等主管下週才有空看。當大家交得更快、更多,主管還得花時間看完、找問題、退件。 所以,就算員工真的把省下的時間拿來做更多工作,也可能只是讓主管桌上多堆幾份提案。 大人學的 Joe 建議,把資深主管腦中的判斷標準整理出來,讓團隊能在交件前搭配 AI 檢查,減少來回修改。 這讓我想到,可以把這些標準寫成 skill,也就是 Agent 執行工作時可以使用的指示與參考資料。員工整理自己熟悉的操作步驟,主管整理審核標準:哪些資料一定要有、哪些條件不符合就退回、哪些情況需要人來決定。 這是我從節目延伸的想法。能先檢查的就先做,主管再處理需要取捨的部分。標準也要跟著實際結果調整,看看有沒有漏掉問題。 科技浪 EP160 也談到信任 Agent 的問題。主持人哈利轉述 Lauren Tan 的分享:她單月能交付數千個 PR,也就是程式碼變更提案;團隊裡連 PM、設計師也能透過 Agent 參與正式功能開發。 哈利提到,Lauren Tan 花力氣整理程式碼、清理不良做法,再加上自動檢查規則、skill 和驗證機制,建立讓團隊能放心使用 Agent 的工作環境。這讓我覺得,除了把工作交出去,還得把 Agent 做事的環境顧好。 套回 HR 知識助手和 GenBI,我也想回頭檢查:文件和資料定義是否清楚?回答與查詢結果要怎麼驗證?這些做好了,才有機會減少每次都要人盯著的部分。 工具變了,工作方式也能一起改 ihower/愛好 AI 工程 Blog 的文章提到 Walmart 當年導入電腦的案例。文章說明,Walmart 透過即時資料共享,讓門市與供應商能依據庫存資訊做決策,改變補貨與協作方式。 這個例子讓我想到,資訊變得容易取得之後,分工也可以跟著改。 回頭看 GenBI,讓不會寫 SQL 的人自己查資料,已經跨過一個門檻。但查到資料以後,哪些事能自己處理,哪些還是得等主管?這一段也需要一起看。 最近聽到企業流程再造的概念:從想達成的成果出發,重新設計整套工作方式。套到我自己的工作,就是把流程攤開:哪些步驟可以省掉?哪些檢查能提早做?哪些事情可以授權,讓工作直接往下走? 我想像未來的公司裡,可能有上百、上千個 Agent,接手我們現在做的許多工作。如果它們做完每件事,都還要等同一個主管批准,今天的瓶頸只會更嚴重。 所以,除了把工作寫成 skill,還得安排好 Agent 怎麼交接、什麼時候找人,以及出了問題由誰處理。這些都需要人先想清楚。 人的時間,要拿來做什麼? 我希望把能自動化的工作交給 Agent,讓人有時間專注在 Agent 還沒辦法代替我們做的事,尤其是溝通。 跨部門合作時,資料整理好了,對方也不一定願意配合。每個部門都有自己的目標和優先順序,你得了解對方在意什麼,說明這件事為什麼值得做,再想辦法說服對方投入時間和資源。這些事情,還是得自己出面談。 往上跟主管爭取支持,往下跟團隊說明方向,也是一樣。Agent 可以幫忙準備資料、整理說法,但實際面對對方的疑慮、協調彼此能接受的做法,仍然需要人花時間。 Agent 可以幫忙分析選項、整理利弊,但最後要怎麼選、願意放棄什麼、承擔什麼風險,還是得由我們決定。結果也要自己負責,這些取捨沒辦法一起交給 Agent。 回頭看 HR 知識助手和 GenBI,我會期待它們幫人省下查文件、查資料的時間,讓人有餘力帶著這些資訊去討論問題、推動事情。這也是我接下來想繼續想的:助手把工作做完之後,人要怎麼接著往下做?把能自動化的工作交給 Agent,把人的時間留給溝通、協調和說服,以及做出決定、承擔結果。參考資料ihower/愛好 AI 工程 Blog〈別再看 AI 預測文了:Cedric Chin 的 Sensemaking 三部曲教你怎麼真正看懂 AI〉https://blog.aihao.tw/2026/05/31/cedric-chin-sensemaking-ai/ 大人學《大人的 Small Talk》EP715〈有了 AI,幫員工省下三天工時,提案卻在主管桌上躺了一週。為什麼大家變快,流程還是卡卡的?〉Apple Podcasts · YouTube 維基百科:企業流程再造(Business Process Re-engineering,BPR)https://zh.wikipedia.org/zh-tw/企业流程再造 科技浪 Tech.wav EP160〈AI 時代的公司將徹底改變!一個人如何創造百倍價值?Anthropic、SpaceXAI 已經讓我們看見答案!〉Apple Podcasts · YouTube
Read More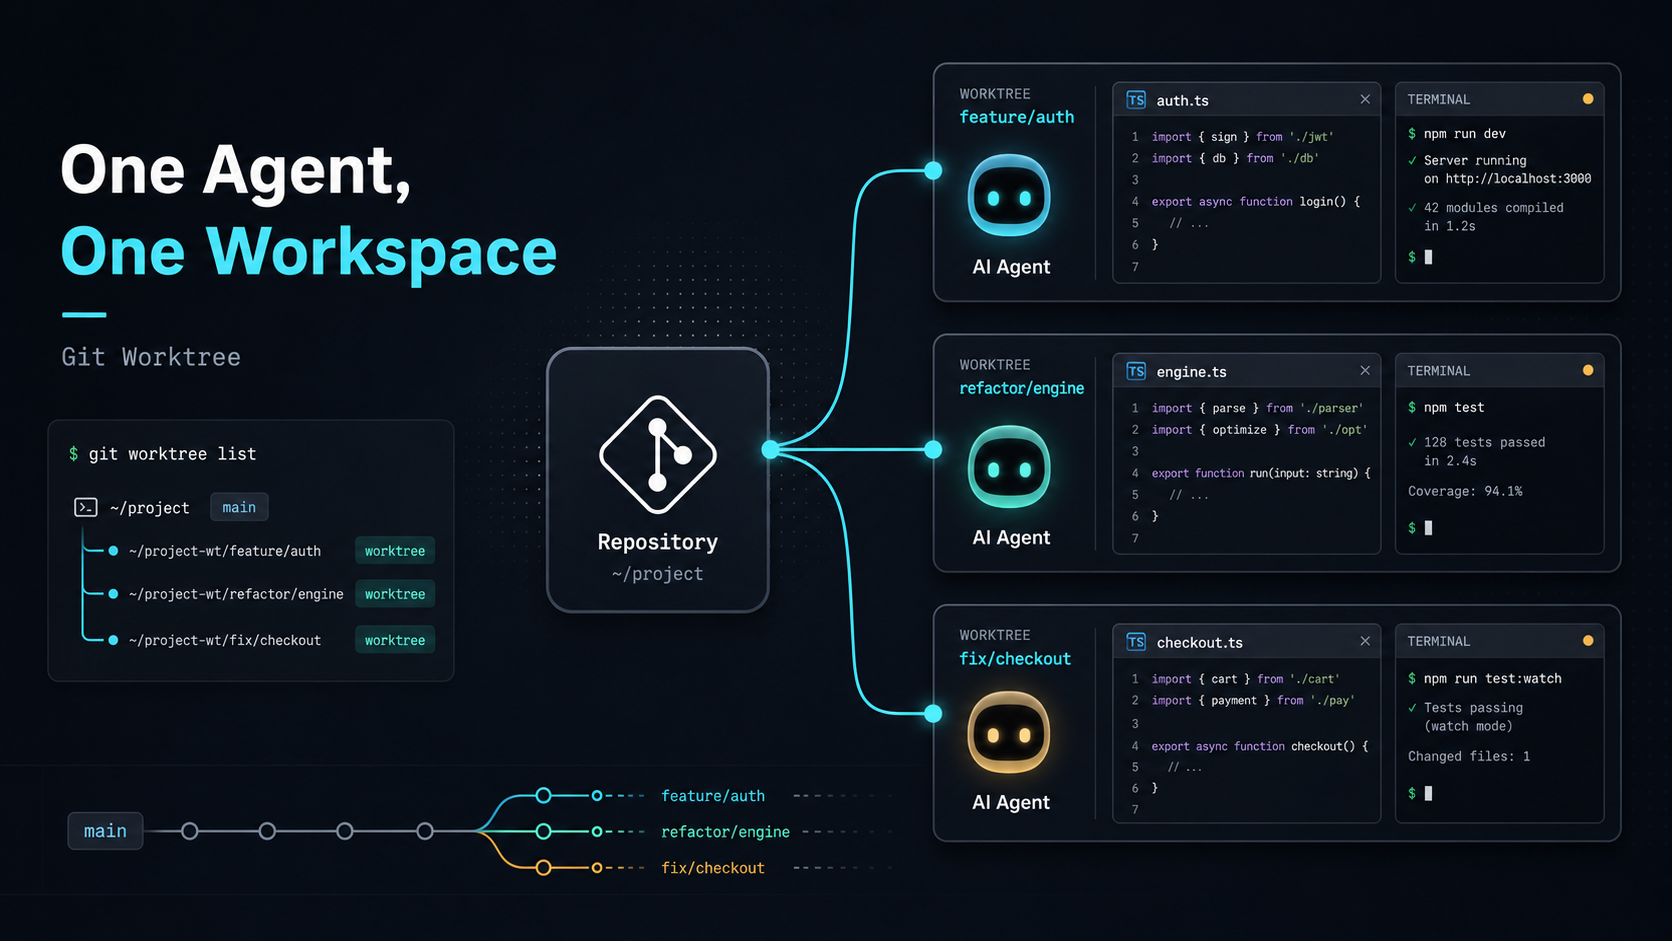
善用 AI Coding Agent(上):當 Branch 不足以支撐多 Agent 協作
AI Coding Agent 已經不只是「幫忙補程式碼」的工具。 我自己也付費使用多個 AI Coding 工具,包含 Cursor、Anthropic Claude Code、OpenAI Codex。這些工具的介面不同,但能力越來越接近:它們可以讀專案、改檔案、跑測試、修錯,甚至花一段時間完成一個比較完整的任務。 這讓我的使用方式開始改變。以前我把 AI 放在 IDE 裡,像一個隨叫隨到的助手;後來我開始把 Agent 當成可以接任務的人。這個轉變聽起來很小,實際上會改變整個工作流程。當 Agent 可以長時間工作,我們要管理的不只指令,也包含它正在使用哪一份專案檔案。這篇是「善用 AI Coding Agent」系列的上篇。我想先記錄一個實際遇到的問題:當我開始讓 Agent 跑長時間任務,原本靠 Git branch 切換的做法很快就不夠用了。 從局部修改開始 我一開始跟 AI 協作的方式,和很多開發者差不多:在 IDE 裡圈選一段程式碼,然後請 AI 幫我做局部修改。 例如:幫我重構這個 function 幫我補上 TypeScript 型別 幫我解釋這段邏輯 幫我把這個 API call 改成另一種寫法 幫我補測試這種方式非常直覺,也很有效。因為操作單位很小,風險也相對容易控制。AI 改完之後,我看一下 diff,覺得可以就接受,不行就退掉。 這個階段的工作方式很單純:我知道現在要改哪裡,AI 只負責處理我指定的那一小塊。它像是加速器,幫我把手上的工作做快一點。 當任務只有幾分鐘,這樣非常夠用。專案目前在哪個狀態、改了哪些檔案、要不要接受修改,都還在我的掌控範圍內。 長時間任務改變了問題 後來我在做 Prompt Engineering 相關工作時,遇到一類很適合交給 Agent 的任務:長時間評估。 例如:跑一批 prompt 評估案例 比較不同 prompt 版本的輸出品質 調整 evaluator 或 LLM-as-a-judge 的判斷邏輯 根據測試結果反覆修改 prompt 整理 trace 或測試報告這類任務通常不會改一個地方就結束。Agent 需要讀專案、跑指令、看結果、修改檔案,再重新驗證。時間可能從幾分鐘拉長到半小時甚至更久。 問題出現在等待期間。當一個 Agent 正在跑 prompt evaluation,我自己還想繼續開發新功能,或再開另一個 Agent 去修 bug。 當時我的想法很直接:能不能讓一個 Agent 在背景處理長時間任務,同時我繼續在另一個分支上開發?直覺答案是開新 branch。 Branch 看起來可以解決 我一開始也是這樣做的。 假設現在有一個主要專案資料夾: luke-tech-blog/我可以為長時間任務開一個 branch: git checkout -b agent/prompt-eval然後讓 Agent 在這個 branch 上執行 prompt 評估。 如果你不熟 Git,可以先把 branch 想成「同一個專案的不同版本路線」。一條路線用來做 prompt 評估,另一條路線用來開發新功能,聽起來很合理。 接著我想繼續開發新的搜尋頁面: git checkout -b feature/search-page這個瞬間,問題才真的浮出來。 同一個專案資料夾,一次只能顯示一個 branch 的檔案。當我從 agent/prompt-eval 切到 feature/search-page,目前資料夾裡的檔案也會跟著換成另一個版本。 這代表正在執行長時間任務的 Agent,看到的專案檔案被我換掉了。 對人類來說,這件事很好理解:我剛剛切了 branch,所以檔案換了。對正在工作的 Agent 來說,它只知道目前資料夾裡的檔案突然變了。它剛剛讀過的內容、跑過的測試、接下來準備修改的檔案,都可能和新的狀態對不上。 可以把它想像成同一張辦公桌上有兩個人在工作。Agent A 正在整理一份報告,我突然把整張桌子的文件換成另一個專案。Agent A 沒有離開,但它眼前的東西已經不是剛剛那一份了。Branch 可以分開專案的不同版本路線,但沒有替每個 Agent 準備自己的工作桌。問題其實在工作空間 這次經驗讓我重新理解問題。 我需要的結構是:同一個專案 不同 branch 不同資料夾 每個資料夾可以同時存在 我切換其中一個資料夾時,不影響另一個 Agent理想上,我希望專案可以長這樣: luke-tech-blog/ mainluke-tech-blog.prompt-eval/ agent/prompt-evalluke-tech-blog.search-page/ feature/search-page這樣我就可以把不同任務分配到不同目錄: Agent A -> luke-tech-blog.prompt-eval Agent B -> luke-tech-blog.search-page每個 Agent 都有自己的 branch,也有自己的資料夾。長時間任務不會因為我切 branch 被中斷,不同 Agent 的修改也不會混在同一個地方。 這是多 Agent 協作第一個很務實的限制:任務可以平行,工作空間也要能平行。 下一篇,我會接著介紹我後來改用的解法:Git worktree。它可以讓同一個專案在不同資料夾同時打開不同 branch,也讓每個 Agent 有自己的工作桌。 小結當 Agent 開始承接長時間任務,每個 Agent 都需要一個不會被別人突然換掉的工作資料夾。善用 AI Coding Agent(下):用 Git Worktree 替每個 Agent 建立獨立工作區
Read More 善用 AI Coding Agent(下):用 Git Worktree 替每個 Agent 建立獨立工作區
上一篇提到,我一開始想用 branch 解決多 Agent 協作的問題,後來發現單一 working directory 會把所有人綁在同一個 checkout 狀態上。善用 AI Coding Agent(上):當 Branch 不足以支撐多 Agent 協作當一個 Agent 正在某個 branch 上跑長時間任務時,如果我在同一個資料夾切到另一個 branch,Agent 實際看到的檔案也會跟著改變。這會讓它的上下文、測試結果、接下來要修改的檔案互相對不上。 我後來採用的解法是 Git worktree。它剛好提供我要的結構:同一個 repo,可以在不同資料夾同時打開不同 branch。Worktree 把 branch 從單一 checkout 狀態中拆出來,讓每個 Agent 都有自己的檔案現場。Worktree 的模型 Git worktree 可以讓同一個 Git repository 擁有多個 working tree。 簡單說,它可以替不同 branch 建立不同的工作目錄。 它不是重新 clone 一份 repository。這些 worktree 仍然共享同一份 Git 物件資料庫,但每個 worktree 都有自己的檔案目錄與 checkout 狀態。 用白話說: project/ mainproject.prompt-eval/ agent/prompt-evalproject.search-page/ feature/search-page每個目錄都有自己的 checkout 狀態。你在 project.search-page 修改檔案,不會改到 project.prompt-eval 的 working directory。 從成本角度看,worktree 不是免費的。每個 worktree 都會有一份實際檔案,空間複雜度可以粗略視為 O(s),s 是 working tree 展開後的檔案大小。它共享 Git object database,所以通常比完整 clone 省,但 node_modules、build cache、.env、產物目錄仍然各自存在。 建立或切換 worktree 的時間成本主要來自 checkout 檔案,粗略是 O(n),n 是需要寫入工作目錄的檔案數。實務上,這筆成本換來的是更穩定的隔離邊界:長時間任務不會被另一個 branch checkout 打斷。 建立 Agent 專用工作區 假設我現在在主專案目錄: cd luke-tech-blog我想替 prompt evaluation 任務建立一個新的 branch 和工作目錄,可以執行: git worktree add ../luke-tech-blog.prompt-eval -b agent/prompt-eval這個指令做了兩件事:建立一個新的 branch:agent/prompt-eval 建立一個新的工作目錄:../luke-tech-blog.prompt-eval接著我就可以進入那個目錄: cd ../luke-tech-blog.prompt-eval從這一刻開始,這個資料夾就是 agent/prompt-eval branch 的工作空間。 原本的 luke-tech-blog 目錄仍然可以停在 main 或其他 branch,不會被這個任務影響。 如果 branch 已經存在,只是想替它建立一個工作目錄,可以這樣做: git worktree add ../luke-tech-blog.search-page feature/search-page這會把 feature/search-page checkout 到 ../luke-tech-blog.search-page。 之後你就可以讓另一個 Agent 在這個資料夾工作。 管理 Worktree 可以用這個指令查看目前 repository 連到哪些 worktree: git worktree list輸出大概會像這樣: /Users/luke/projects/luke-tech-blog abc1234 [main] /Users/luke/projects/luke-tech-blog.prompt-eval def5678 [agent/prompt-eval] /Users/luke/projects/luke-tech-blog.search-page 789abcd [feature/search-page]任務完成、branch merge 之後,可以移除 worktree: git worktree remove ../luke-tech-blog.prompt-eval如果手動刪掉資料夾,Git 可能還保留著 worktree 紀錄。這時可以執行: git worktree prune這會清掉已經不存在的 worktree 紀錄。 指令小結日常使用先記住三個指令就夠:git worktree add、git worktree list、git worktree remove。我的多 Agent 分配方式 使用 Git worktree 之後,我的多 Agent 工作流會變成這樣: git worktree add ../project.prompt-eval -b agent/prompt-eval git worktree add ../project.search-page -b agent/search-page git worktree add ../project.refactor-card -b agent/refactor-card然後我會把任務講清楚: 你在 ../project.prompt-eval 這個 worktree 工作。 請專注處理 prompt evaluation 任務。 不要修改 UI、部署設定或無關的資料結構。 完成後請回報修改檔案、測試結果與風險。另一個 Agent 則可能是: 你在 ../project.search-page 這個 worktree 工作。 請實作搜尋頁面的前端功能。 不要修改 prompt evaluation 相關檔案。 完成後請執行 build,並整理主要 diff。這裡要建立的是一個可重複的工作流:一個 Agent 對應一個明確任務 一個任務對應一個 branch 一個 branch 對應一個 worktree 每個 worktree 有自己的檔案狀態這個規則可以降低 review 成本。每個 worktree 最後對應一組 diff,工程師可以用一般 Git 流程看變更、跑測試、決定 merge 順序。 它解決的痛點 Git worktree 最直接解決的是檔案工作區被互相影響的問題。 在單一資料夾裡,切 branch 會改變整個 working directory。你、Agent A、Agent B 共用同一個檔案現場;只要其中一方切 branch,其他工作都會受影響。 使用 worktree 之後,每個 Agent 都有自己的桌子: project/ mainproject.prompt-eval/ agent/prompt-evalproject.search-page/ agent/search-pageproject.refactor-card/ agent/refactor-card這帶來幾個好處:長時間任務不會因為你切 branch 被中斷 不同 Agent 的修改不會混在同一個 working directory 每個任務的 diff 更容易 review 可以保留一個乾淨的主工作區 多個 Agent 才真的有機會平行工作工作流小結Worktree 不會讓 merge conflict 消失,但它會讓每個 Agent 在任務執行期間擁有穩定的檔案世界。人類負責協調邊界 AI Coding Agent 變強之後,人類的工作開始往協調者靠近。 我現在更常做這些事:定義任務邊界 選擇適合交給 Agent 的工作 分配不同 worktree 限制修改範圍 要求 Agent 執行驗證 Review diff 決定哪些變更可以 mergeGit worktree 的價值就在這裡。它提供工程流程需要的隔離邊界,讓多個 Agent 可以同時工作,也讓人類保留 review、驗證、整合的控制權。 常見注意事項 使用 worktree 時,有幾個地方要注意。 第一,同一個 branch 通常不能同時被兩個 worktree checkout。這是 Git 的保護機制,避免同一條工作線在兩個地方同時被修改。 第二,不要直接把 worktree 建在原本 repo 的子目錄裡。否則有些工具在搜尋、格式化、跑測試時,可能會把其他 worktree 也掃進去。 我會比較建議這種結構: projects/ luke-tech-blog/ luke-tech-blog.prompt-eval/ luke-tech-blog.search-page/ luke-tech-blog.refactor-card/第三,多個 worktree 可能各自需要安裝 dependencies。即使它們共享 Git 物件,工作目錄裡的 node_modules、build cache、.env 等檔案仍然要自己管理。 這裡推薦一個實戰細節:如果你的專案使用 pnpm(非常適合 Astro 專案),因為其獨特的「全域硬體連結儲存庫(Global Hard-Link Store)」設計,在每個 worktree 目錄執行 pnpm install 不僅能秒級完成,而且幾乎不額外佔用磁碟空間。這能完美解決多 worktree 重複安裝套件又慢又佔空間的痛點。 此外,為了避免在桌面開啟多個 Cursor 或 VS Code 視窗造成的混亂,你可以使用 VS Code 的 Multi-root Workspace 功能。在根目錄建立一個 .code-workspace 檔案,同時引入主目錄與多個活躍的 worktree: { "folders": [ { "path": "luke-tech-blog" }, { "path": "../luke-tech-blog.prompt-eval" }, { "path": "../luke-tech-blog.search-page" } ] }這樣一來,你就可以在同一個 Cursor 視窗的側邊欄中,同時管理與檢視不同工作區的檔案與變更,協調邊界與審查 diff 都會變得極度輕鬆。 第四,worktree 只能隔離工作空間,不能消除 merge conflict。 如果兩個 Agent 同時修改同一個核心檔案,最後合併時還是可能衝突。Worktree 能避免工作期間互相踩檔案狀態,任務邊界仍然要由人類先設計好。 我會優先把這些任務分到不同 worktree:長時間評估任務 不同 feature 的開發 bug fix 文件更新 測試補強 UI 與 backend 可以明確分開的修改 refactor 範圍清楚的小型重構我會避免同時平行丟出這些任務:多個 Agent 同時重構同一個核心 abstraction 多個 Agent 同時修改 shared schema 多個 Agent 同時調整全域設定 任務描述只有「幫我優化整個專案」小結 當 AI Coding Agent 只幫我們改一小段程式碼時,單一 IDE、單一工作目錄通常就夠了。當 Agent 開始執行長時間任務,甚至多個 Agent 同時處理不同 feature,工作空間管理會變成第一個要補上的工程環節。 Git worktree 提供了一個很實用的基礎。每個 Agent 有自己的 branch 與資料夾,不同任務在檔案層級被隔離;人類負責定義任務、檢查結果、整合變更。 結論善用 AI Coding Agent 的第一步,是替每個長時間任務安排穩定、可驗證、可回收的工作空間。
Read More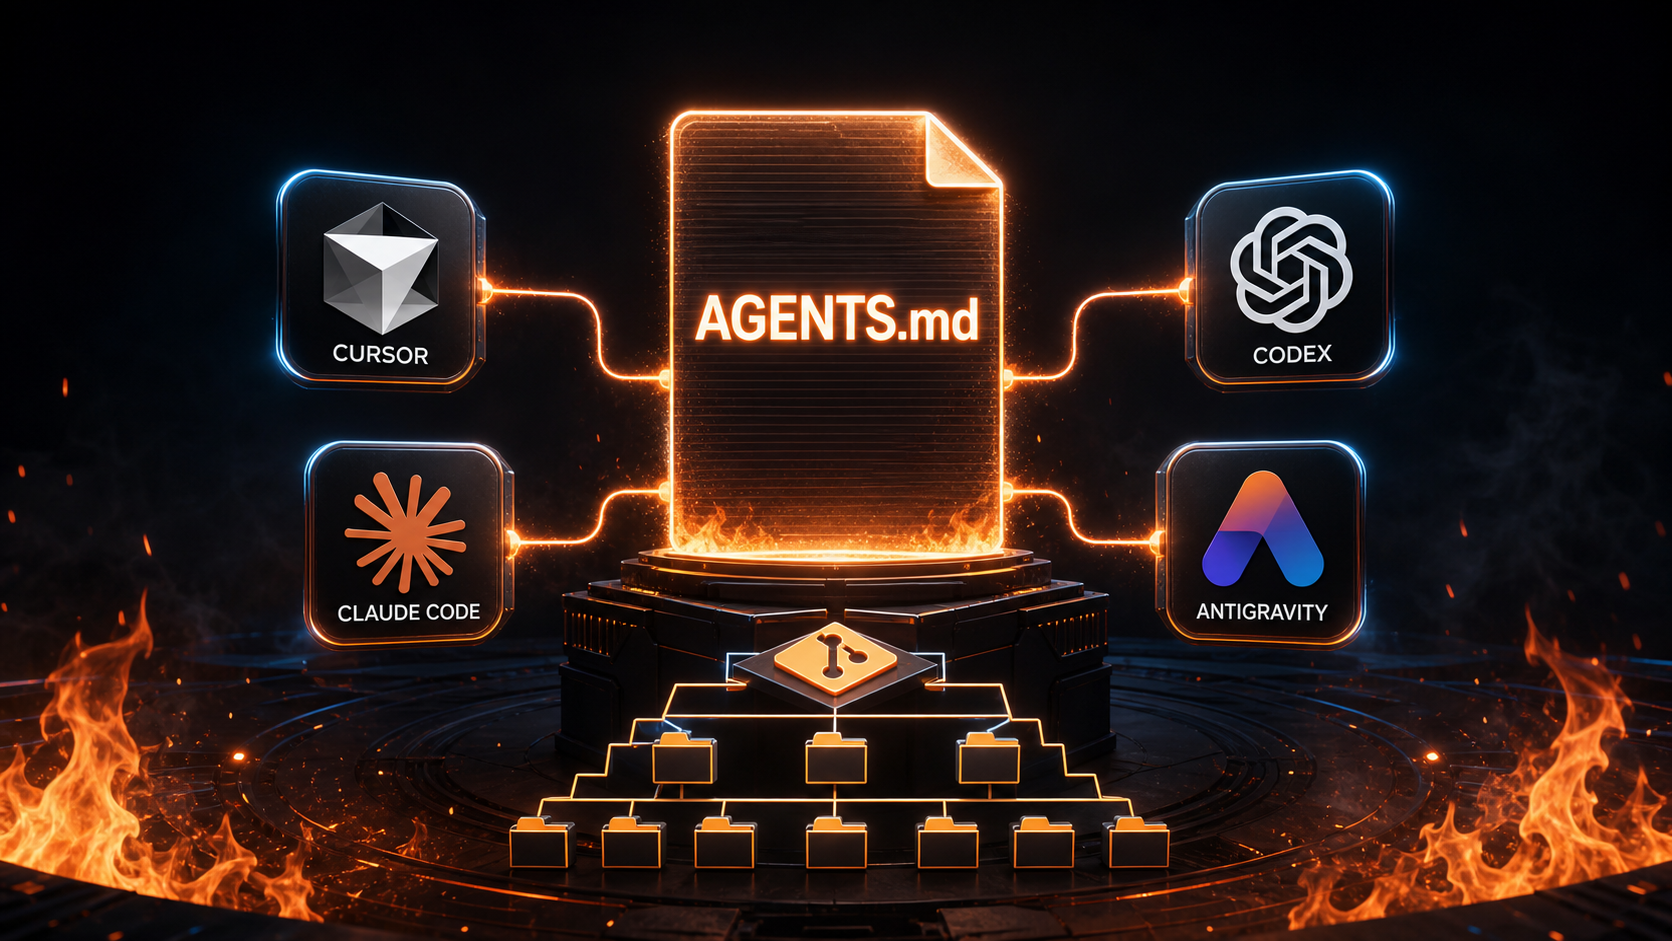
一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(上)
AI 程式開發工具會一直增加。當 Cursor、Claude Code、Codex、Antigravity 各自帶著一份規則檔進專案,幾個月後常會發現規則彼此已經說了不同的事。 我現在把專案當成穩定入口:共用規則放在 AGENTS.md,完整任務流程放在 .skills/,工具需要特定探索位置時只放輕量 adapter。工具換了,真正需要維護的內容仍然留在專案裡。更新(2026-08-24):本文已配合本專案的原生 skill 探索 adapter 更新。實作細節與 Antigravity、Cursor 的使用方式請接著閱讀 Part 2。1. 四個工具如何接到同一份專案規則 四個工具的入口不同,但它們都可以回到同一個原則:把跨工具、長期穩定的內容留在專案,讓工具專屬設定只處理載入方式。 Codex:AGENTS.md 是專案指引的指令鏈 Codex 在開始工作前會讀取 AGENTS.md。它會從專案根目錄一路走到目前工作目錄,逐層合併規則;較靠近工作目錄的 AGENTS.md 或 AGENTS.override.md 會排在後面,因此能覆寫前面的通用規則。 這很適合放全專案都要遵守的資訊:專案結構與常用指令 建置、型別檢查與測試規則 提交與審查的期待 共用 skills 的唯一來源如果 src/content/posts/ 有特別的工作限制,可以在那個資料夾新增較近的指引。全域規則仍然放在根目錄的 AGENTS.md,讓新進專案的 agent 一開始就知道基本工作方式。 Claude Code:用 CLAUDE.md 匯入同一份指引 Claude Code 的預設入口是 CLAUDE.md。既然專案的共用規則已經放在 AGENTS.md,CLAUDE.md 只需要保留官方匯入語法: @AGENTS.md這個檔案是 adapter,不承載另一份規則。指令、驗證方式與 Git 流程改動時,只修改 AGENTS.md,Claude Code 也會讀到同一個版本。 Antigravity:把共用規則放進可執行的任務脈絡 Antigravity 適合處理跨編輯器、終端機、瀏覽器的完整任務。對這個專案,我會在任務一開始要求 agent 讀 AGENTS.md,再依 skills 索引開啟命中的 .skills/<name>/SKILL.md。 例如文章更新可以直接交代: 更新中英文文章。先讀 AGENTS.md 與命中的 skill,完成後跑 skills:check、npm run check、npm run build。接著讓 agent 依序改內容、執行指令、啟動預覽;最後再從計畫、截圖或瀏覽紀錄檢查成果。這是任務執行層的安排,專案的流程本體仍然只有 .skills/ 那一份。 Cursor:共用規則用 AGENTS.md,路徑觸發用 .cursor/rules Cursor 可以把根目錄的 AGENTS.md 當成簡單的專案指引。這足以承接整個專案都適用的規則。 當某條規則只適用於一類檔案時,再加入 .cursor/rules/*.mdc。例如文章被開啟或修改時,讓規則檔只指向完整流程: --- description: Apply the blog writing workflow globs: src/content/posts/**/*.md alwaysApply: false ---Read and follow `.skills/tech-blog-polish/SKILL.md` before editing this post.這個 adapter 只回答「什麼時候載入」,不複製文章結構與語氣規則。Cursor 的檔案路徑能力保留下來,流程也不會分裂成多份。 2. 專案的最小共用策略 我會把規則拆成三個層次:AGENTS.md 放穩定指引,.skills/ 放完整任務流程,工具資料夾放產生的或依路徑套用的 adapters。這個分法讓每個檔案都有單一責任,也讓審查時能快速判斷一條規則該放在哪裡。 Luke-Tech-Blog/ ├── AGENTS.md # 專案指引 ├── CLAUDE.md # 匯入 AGENTS.md ├── .skills/ # 完整且唯一的流程 ├── .claude/skills/ # 產生的原生探索 adapter ├── .agents/skills/ # 產生的原生探索 adapter └── .cursor/rules/ # 可選的檔案路徑觸發規則AGENTS.md 的內容保持短而穩定: ## Repository Expectations- Keep the complete workflow only in `.skills/<skill-name>/SKILL.md`. - `.claude/skills/` and `.agents/skills/` are generated native-discovery adapters. - Run `npm run skills:sync` after changing skill frontmatter..skills/ 才放會反覆演進的細節,例如文章潤稿的讀者設定、段落結構與語氣,或 Git 審查的檢查順序與提交規則。 需要 Claude Code 與 Codex 的原生探索時,執行同步腳本產生 adapter: npm run skills:sync npm run skills:check前者更新產生檔,後者只驗證同步狀態。這讓失步變成可以在提交前或 CI 明確攔下來的錯誤。一份共用規則能走得久,前提是每個工具只帶走它需要的入口。結論:先讓規則收斂,再讓工具各自發揮 四個工具各有適合的使用方式:Codex 與 Claude Code 可直接接到共用指引;Antigravity 適合執行長任務並留下可檢查的成果;Cursor 適合按檔案路徑自動附加規則。 先把 AGENTS.md 與 .skills/ 定為唯一來源,後面的工具整合才不會變成持續複製文件的工作。 下一篇會回到這個部落格專案,實際展示 Claude Code 與 Codex 的原生探索 adapters,以及 Antigravity、Cursor 在同一份流程上的使用方式。一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(下)參考資料OpenAI Codex:Custom instructions with AGENTS.md Claude Code:How Claude remembers your project Cursor:Rules Google Antigravity:agentic development platform
Read More 一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(下)
上一篇先整理了官方文件的共同方向:AGENTS.md 可以成為專案的共用指引。這一篇回到我自己的部落格專案,說明我如何讓 Claude Code 與 Codex 直接發現同一組 skills。一份 AGENTS.md,讓多個 AI 程式開發 Agent 共享專案規則(上)更新(2026-08-24):這個專案已加入可提交的原生探索 adapters。.skills/ 仍是唯一完整流程,.claude/skills/ 和 .agents/skills/ 只保留產生出的入口。我的目標很明確:專案指引只維護一份 任務流程只維護一份 工具專屬檔案只做 adapter 團隊共用的內容進 Git這樣換工具時不用重寫規則。接下來我把實作分成兩段:先處理 Claude Code 與 Codex 的原生探索,再補上 Antigravity 與 Cursor 該怎麼接到同一份專案規則。 1. Claude Code 與 Codex:一份流程,多個原生入口 上一版架構已經讓 agent 可以從 AGENTS.md 找到 .skills/。實際使用時,工具開啟專案後若能直接掃描自己的 skills 目錄,任務發現會更自然;我不必在每個指令裡重複提醒「先去 .skills/ 找流程」。 這次完成後的結構如下: Luke-Tech-Blog/ ├── AGENTS.md ├── CLAUDE.md ├── .skills/ │ ├── README.md │ ├── tech-blog-polish/ │ │ └── SKILL.md │ ├── git-change-commit-review/ │ │ └── SKILL.md │ └── linkedin-blog-promo/ │ └── SKILL.md ├── .claude/ │ └── skills/ │ ├── tech-blog-polish/ │ │ └── SKILL.md │ ├── git-change-commit-review/ │ │ └── SKILL.md │ └── linkedin-blog-promo/ │ └── SKILL.md ├── .agents/ │ └── skills/ │ ├── tech-blog-polish/ │ │ └── SKILL.md │ ├── git-change-commit-review/ │ │ └── SKILL.md │ └── linkedin-blog-promo/ │ └── SKILL.md └── scripts/ └── sync-skills.mjsAGENTS.md 依然是專案指引的入口,放常用指令、驗證方式、專案結構與 Git 流程。CLAUDE.md 仍然只匯入它: @AGENTS.md真正的任務流程放在 .skills/<skill-name>/SKILL.md。兩個工具目錄裡的同名檔案則是 adapter,讓 Claude Code 與 Codex 可以用各自的原生探索找到同一個 skill。 完整流程只寫一次 adapter 的內容刻意很短。以 tech-blog-polish 為例,產生出的檔案只保留 skill 的 frontmatter,以及導向唯一來源的指示: --- name: tech-blog-polish description: Polish technical blog articles for this project... ---# Canonical Skill完整流程在 `.skills/tech-blog-polish/SKILL.md`。先讀該檔,再依其步驟執行。這個設計刻意避開把完整內容複製三份。文章潤稿規則、Git 審查規則,甚至未來新增的流程,都只修改 .skills/ 內的 SKILL.md。 AGENTS.md 也明確說出這個責任分工: Keep the complete workflow only in `.skills/<skill-name>/SKILL.md`. `.claude/skills/` and `.agents/skills/` are generated native-discovery adapters..skills/ 是完整流程的唯一來源;原生 adapter 只負責讓工具找到它。用腳本產生 adapter,讓失步變成可檢查的錯誤 Windows symlink 在不同開發環境仍可能遇到權限差異。因此這個專案用 Node.js 小腳本 scripts/sync-skills.mjs 產生檔案,而非依賴 symlink。 它會逐一讀取 .skills/ 的子目錄,確認 SKILL.md 有 name 與 description frontmatter,再把精簡 adapter 寫到兩個原生探索位置: .skills/<name>/SKILL.md ├─> .claude/skills/<name>/SKILL.md └─> .agents/skills/<name>/SKILL.md日常修改後跑: npm run skills:syncCI 或提交前則跑: npm run skills:check--check 不會寫檔。只要唯一來源的 skill frontmatter 或 adapter 內容沒有同步,它就會列出需要更新的檔案並以失敗結束。這讓「有人改了 .skills/ 卻忘了更新 adapter」成為明確、可重現的問題。 2. 補充:Antigravity 與 Cursor 的使用方法 這兩個工具不需要複製另一份 skill。它們適合補上不同層次的工作方式:Antigravity 處理跨編輯器、終端機、瀏覽器的任務執行;Cursor 處理與特定檔案路徑綁定的即時規則。 Antigravity:從 AGENTS.md 進入,交給 agent 完成整段任務 在 Antigravity 開啟這個專案時,我會先讓 agent 讀根目錄的 AGENTS.md。裡面的 skills 索引會指向 .skills/;任務命中後,agent 再讀對應的唯一來源 SKILL.md。這個順序讓專案指引、任務流程與工具操作各自有清楚的位置。 例如要更新一篇文章,我會直接交代任務範圍與驗證要求: 更新中英文 Part 2,先讀 AGENTS.md 與命中的 skill,完成後跑 skills:check、npm run check、npm run build。Antigravity 的 Manager Surface 適合這類需要編輯、跑指令與看預覽的長任務。完成後我會從它產生的計畫、截圖或瀏覽紀錄檢查結果,再決定是否送出下一輪修正。專案裡的 .skills/ 不需要為它另開副本。 Cursor:把檔案路徑觸發留給 .cursor/rules Cursor 也能讀根目錄的 AGENTS.md,因此全專案的規則仍然只有一份。當需求和檔案位置有直接關係時,才在 .cursor/rules/ 放一個短 adapter。例如文章被開啟或修改時,讓 Cursor 載入文章潤稿流程: --- description: Apply the blog writing workflow globs: src/content/posts/**/*.md alwaysApply: false ---Read and follow `.skills/tech-blog-polish/SKILL.md` before editing this post.英文文章可以用另一個相同概念的 rule,將 globs 指到 src/content/posts-en/**/*.md。這個 .mdc 檔只負責觸發,不重述文章結構、語氣與驗收細節;完整規則仍然在 .skills/tech-blog-polish/SKILL.md。 這樣分工後,Cursor 的自動附加規則解決「何時載入」,Antigravity 的 agent 任務解決「如何執行整段工作」,而 Claude Code 與 Codex 透過原生 adapters 解決「怎麼發現 skill」。四個工具都回到同一份流程。 結論:讓工具找到規則,也讓團隊只維護一份規則 AI 程式開發工具還會繼續變,skills 探索的目錄也可能不同。把流程直接複製到每個工具資料夾,長期一定會增加維護成本。 現在這個專案讓 .skills/ 承擔完整內容,腳本產生 Claude Code 與 Codex 的原生 adapters,再用 skills:check 守住同步。新工具要加入時,我只需要新增一個輕量 adapter,不必搬動整套流程。原生探索可以因工具而異;團隊共用的流程應該只有一個來源。參考資料OpenAI Codex:Agent Skills Anthropic:Agent Skills Cursor:Rules Google Antigravity:Agent 導向開發平台
Read More
PostgreSQL 效能優化(上):LIKE 和 Regex,哪個比較快?
這篇文章是我在工作上真的卡住過的一次效能問題。中間繞了一些路,最後才把真正的瓶頸抓出來。 本篇為上集,先談 LIKE 與 Regex 的抉擇與 I/O/CPU 迷思;接續兩集分別深入:中集:用 EXPLAIN 看見 Seq Scan 的真相 下集:用 Array + GIN 把標籤變成索引上集:當 LIKE 遇上 Regex,到底差在哪? 1. 問題背景(白話版) 我在工作上接了一批 ETL 後的資料。每筆資料裡,很多標籤被塞在同一個欄位,用 ; 串起來,像這樣: tag1;tag2;tag3;tag_VIP;tag_inactive 當我要找特定標籤時,最直覺是寫很多個 LIKE。 2. 同事一句提醒,直接點到問題 同事說:「把多個 LIKE 合成一個 Regex,通常會更快。」 我第一反應是:「沒有索引的話,不是都要整張表一筆一筆看過去嗎?那真的會快多少?」 3. 我們都沒錯,只是看的是不同成本 後來我才搞懂,我們其實切入點不同:我先看讀取成本(I/O),同事先看運算成本(CPU)。我看的是 I/O(讀資料成本)沒有索引時,資料庫通常還是要掃很多資料。這件事不會因為你改成 Regex 就消失。 同事看的是 CPU(運算成本)多個 LIKE 代表同一列要重複比對很多次;合成一個 Regex,通常可把「重複比對」變少。用比喻來說:多個 LIKE 像是同一本書翻很多輪,每次找一個關鍵字。 單一 Regex 像是一輪閱讀就把多個關鍵字一起判斷。4. 這篇上集我最想說的事 如果資料量還小,Regex 可能已經很有感。但資料一大,只換語法通常不夠,最後還是得讓資料庫用不同方式找資料。 結論Regex 可以先減輕 CPU 壓力,但只要查詢還在掃整張表,I/O 依然會是主瓶頸。中集從 EXPLAIN ANALYZE 拆解 LIKE 與 Regex 的真實成本,下集則動手實作 Array + GIN:PostgreSQL 效能優化(中):用 EXPLAIN 看見 Seq Scan 的真相 PostgreSQL 效能優化(下):用 Array + GIN 把標籤變成索引
Read More PostgreSQL 效能優化(中):用 EXPLAIN 看見 Seq Scan 的真相
若你還沒讀過 LIKE/Regex 與 I/O、CPU 兩條戰線,請先看上集;想直接動手做的,可以跳到下集:上集:當 LIKE 遇上 Regex 的觀念碰撞 下集:用 Array + GIN 把標籤變成索引問題升級:Regex 幫了 CPU,但整體還是不夠快 上集的結論提到 Regex 能降低每列字串比對的 CPU 成本,但當資料規模上看千萬、億級時,真正決定延遲與吞吐的是 I/O 與存取路徑,而不是字串語法本身。 這一集要做的就一件事:用 EXPLAIN ANALYZE 把計畫攤開,定位 LIKE / Regex 寫法在哪一步把整張表的 I/O 給綁死了。 確認瓶頸位置之後,下集再動手換存取路徑。關鍵分析:用 EXPLAIN 與複雜度看主導成本註:以下 EXPLAIN 與 SQL 已將 schema、表名、欄位名匿名化處理(例:customers、tag_dictionary、balance 等)。執行統計(rows、loops、Rows Removed、Buffers)來自一份測試資料集的 EXPLAIN ANALYZE 實測,僅作為「結構辨識」範例——關注每個節點長什麼樣、條件擺在哪、有沒有走索引;絕對數字會隨資料量變化,不代表生產環境。用 EXPLAIN ANALYZE 攤開 LIKE 版的計畫,第一個刺眼的訊息是 這條查詢對主表 Seq Scan 了三次。要弄懂為什麼會這樣,必須回到 SQL 語法本身。 從 SQL 找出每一個 Seq Scan 的源頭 把 LIKE 版本的 SQL 簡化、標出每個會碰到主表的位置: WITH product_dict AS ( -- ← 觸發點 1 SELECT DISTINCT product_id, product FROM customers WHERE product <> '' ) SELECT ... FROM customers AS main -- ← 觸發點 2 INNER JOIN product_dict ... WHERE main.segment = 'core' AND lower(main.levels) LIKE '%lv1%' AND lower(main.excluded_levels) NOT LIKE '%ex001%' AND lower(main.excluded_levels) NOT LIKE '%ex022%' AND date_trunc('MONTH', main.etl_date) = date_trunc('MONTH', (SELECT MAX(etl_date) FROM customers)); -- ← 觸發點 3三個觸發點在 SQL 上看起來很無辜:一個 CTE、一個主 FROM、一個 MAX() 子查詢。但對 PostgreSQL 來說,每一個都是「再把表打開讀一次」的指令。對應到 EXPLAIN: -> Aggregate -- 觸發點 3:InitPlan 1 -> Seq Scan on customers Buffers: shared hit=159-> Seq Scan on customers main -- 觸發點 2:主 FROM Filter: segment = 'core' AND lower(levels) ~~ '%lv1%' AND lower(excluded_levels) !~~ '%ex001%' AND lower(excluded_levels) !~~ '%ex022%' AND date_trunc('MONTH', etl_date) = (InitPlan 1).col1 Rows Removed by Filter: 3806 Buffers: shared hit=318-> Seq Scan on customers -- 觸發點 1:CTE 內部 Filter: product <> '' Rows Removed by Filter: 3835 Buffers: shared hit=159四個關鍵訊號:Seq Scan 出現三次:每一次都代表「主表逐列翻一遍」。 每個 Filter 之後的 Rows Removed 幾乎等於該節點吐出的 rows:被讀進來的列絕大多數只是為了被丟掉。 沒有條件被歸到 Index Cond:所有 WHERE 條件都落在 Filter 內,PostgreSQL 找不到任何走索引的入口。 三段 Buffers: shared hit 加總接近主表的全部 page 數:實質上整張表被完整讀了三次。為什麼 LIKE 把每一個掃描都鎖死在 Seq Scan PostgreSQL 預設只會挑 B-tree 索引來規劃查詢(除非你明確替欄位建了 GIN、GiST 等其他類型)。B-tree 是有序樹,能加速的查詢條件只有一種共通特徵:能在樹中定位出起始 key——例如 name = 'Luke' 或 name LIKE 'Lu%',B-tree 都能從特定節點往下走。一旦條件失去這個性質,索引就無從切入。回到三個觸發點的條件:lower(levels) LIKE '%lv1%':前後都是 %,B-tree 沒入口。 lower(excluded_levels) NOT LIKE '%ex001%':NOT LIKE 等於要求對每一列驗證「條件不成立」,索引天生不擅長否定查詢。 date_trunc('MONTH', etl_date) = ...:欄位被函數包住,B-tree 找不到對應的 key(除非建 expression index)。所以三個觸發點全部退回 Seq Scan 的根因只有一個:LIKE 加上「函數包欄位」的寫法根本沒給 PostgreSQL 任何走索引的入口。 改寫成 Regex 之後,SQL 跟 EXPLAIN 變這樣 把兩條 NOT LIKE 改用 Regex(從字典表動態組出 alternation pattern)後,SQL 結構整個換掉: WITH remove_list AS ( -- ← 觸發點 1 SELECT '(^|;|,)(' || REPLACE(string_agg(TRIM(code), '|'), ' ', '') || ')($|;|,)' AS regex_pattern FROM tag_dictionary WHERE kind = 'exclude' AND category IN ('low_marketing', 'private_bank') ) SELECT cluster_list.display_name, main.etl_date, product_list.product, SUM(main.balance)::numeric / COUNT(DISTINCT main.customer_id) AS avg_balance FROM ( SELECT * FROM customers -- ← 觸發點 2 WHERE customer_id <> '' AND segment = 'core' AND etl_date = (SELECT MAX(etl_date) FROM customers) -- ← 觸發點 3 ) AS main LEFT JOIN ( SELECT DISTINCT '%' || lower(code) || '%' AS level_code, display_name FROM tag_dictionary -- ← 觸發點 4 WHERE display_name = 'HVIP' ) AS cluster_list ON main.levels LIKE cluster_list.level_code LEFT JOIN ( SELECT DISTINCT product_id, product FROM customers -- ← 觸發點 5 WHERE customer_id = '' AND product <> '' ) AS product_list ON main.product_id = product_list.product_id CROSS JOIN remove_list WHERE COALESCE(main.excluded_levels, '') !~ remove_list.regex_pattern AND cluster_list.display_name <> '' AND main.product_id <> 0;五個觸發點對應 EXPLAIN 的五個 Seq Scan: -> Aggregate -- 觸發點 3:InitPlan 1(同 LIKE 版) -> Seq Scan on customers Buffers: shared hit=159-> Aggregate -- 觸發點 1:remove_list CTE -> Seq Scan on tag_dictionary Filter: kind = 'exclude' AND category IN ('low_marketing','private_bank') Buffers: shared hit=4-> Seq Scan on tag_dictionary -- 觸發點 4:cluster_list 子查詢 Filter: display_name = 'HVIP' Buffers: shared hit=4-> Seq Scan on customers main -- 觸發點 2:主 FROM Filter: customer_id <> '' AND product_id <> 0 AND segment = 'core' AND etl_date = (InitPlan 1).col1 Rows Removed by Filter: 3308 Buffers: shared hit=318-> Seq Scan on customers -- 觸發點 5:product_list 子查詢 Filter: product <> '' AND customer_id = '' Rows Removed by Filter: 3835 Buffers: shared hit=159主表 customers 還是被 Seq Scan 三次(觸發點 2、3、5),完全沒少;多出來的兩次 Seq Scan 在字典表上(觸發點 1、4)。 更關鍵的是,原本擠在主 Filter: 裡的 LIKE 與 Regex,現在被拆到兩層 Join Filter:: -> Nested Loop -- 套 Regex Join Filter: COALESCE(excluded_levels, '') !~ regex_pattern-> Nested Loop -- 套 LIKE on levels Join Filter: levels ~~ ('%' || lower(code) || '%')LIKE 版 vs Regex 版的結構性對照項目 LIKE 版 Regex 版主表 Seq Scan 次數 3 3字典表 Seq Scan 次數 0 2LIKE / Regex 條件擺在哪 主表的 Filter:(隨 Seq Scan 同時評估) Join Filter:(join 階段才評估)主表 Seq Scan 直接吐出的列 已經套完 LIKE 條件 只套基本條件,字串檢查留待 join 處理兩個結構性結論:主表的 Seq Scan 次數沒變:3 次仍然 3 次。Regex 沒有解決「掃幾次」這件事。 LIKE / Regex 從 Filter 升到 Join Filter:字串檢查被推到 join 階段,主表必須先把所有通過基本條件的列都吐進 join,才開始用 LIKE / Regex 篩。Regex 在 per-row CPU 上理論上更輕(下面解釋為什麼),這個結構性改寫等於把省下的力氣再吐回去。也就是說:SQL 結構決定要掃幾次表,LIKE 或 Regex 只決定每次掃描如何檢查每一列。 為什麼理論上 Regex 能把 CPU 從 $O(N \times M)$ 壓成 $O(N)$ 要理解這個差別,得先補一個概念:狀態機(finite automaton)就是一台「邊讀字元、邊跳狀態」的小機器——給它一個字串,它依序看每一個字元,決定要跳到哪個狀態,最後告訴你「有沒有匹配成功」。Regex 引擎在執行前會把整個 pattern 翻譯成這種結構,常見有兩個變體:DFA(Deterministic Finite Automaton,確定性自動機):每個狀態看到一個字元只有一條轉移路徑,執行快但狀態總數可能爆炸。 NFA(Nondeterministic Finite Automaton,非確定性自動機):每個狀態同一個字元可以有多條轉移路徑,狀態少但執行可能要 backtrack。PostgreSQL 用的是 NFA-based 引擎。對 alternation (ex001|ex022|ex045),編譯出來的狀態機長這樣(簡化): ┌─ 0 → 0 → 1 ✓ ex001 start ─→ e ─→ x ─→ 0 ──────┼─ 2 → 2 ✓ ex022 └─ 4 → 5 ✓ ex045關鍵是共用前綴 ex0 只被處理一次。讀進輸入字串後,每讀一個字元,整台狀態機同時推進所有分支,掃過字串一輪就等於一次判斷完所有替代項。 把這套機制套回查詢:多 LIKE:M 個 pattern 各自獨立、不共用工作,每列要跑 M 次完整字串比對 → CPU ~ $O(N \times M)$ 單 Regex:M 個替代項合併成同一台狀態機,每列只走一次 → CPU ~ $O(N)$省的是「每列的 CPU」,沒有改變「要不要再掃一次表」這件事。 三種寫法的成本主導者 定義符號:N = 主表列數、M = 條件數、K = 命中列數。寫法 每次掃描的 CPU 每次掃描的 I/O多 LIKE ~ $O(N \times M)$ ~ $O(N)$ 全表掃單 Regex ~ $O(N)$ ~ $O(N)$ 全表掃Array + GIN ~ $O(\log N + K)$ 走索引 + 抓命中頁LIKE 與 Regex 只動 CPU 那一欄,I/O 那欄一動沒動;而且 SQL 結構讓查詢碰主表幾次,整體成本就是上表那一欄按次累計。要根本改變每一次掃描的形狀,得讓 Seq Scan 退場、換 Index Scan 上場。 說白了,真正拉開差距的是有沒有讓查詢改走索引那條路。中集小結 到這裡我們已經看清三件事:SQL 結構決定要碰主表幾次(CTE、子查詢、MAX() 各算一次觸發點) LIKE 加上「函數包欄位」讓每一次掃描都鎖死成 Seq Scan:B-tree 只能加速能定位起始 key 的條件,本案三個觸發點全部不符合 Regex 改寫不會減少掃描次數:狀態機只壓 per-row CPU,不改變存取路徑要根本拉開差距,得直接換索引型存取路徑——下集動手做:PostgreSQL 效能優化(下):用 Array + GIN 把標籤變成索引
Read More PostgreSQL 效能優化(下):用 Array + GIN 把標籤變成索引
若你還沒讀過前兩集的問題定位與 EXPLAIN 拆解:上集:當 LIKE 遇上 Regex 的觀念碰撞 中集:用 EXPLAIN 看見 Seq Scan 的真相從觀察到動手:真正要換掉的是存取路徑 中集確認的事實是:LIKE 與 Regex 都讓 PostgreSQL 規劃出全表 Seq Scan,因為 B-tree 索引在 '%xxx%' 條件下找不到入口。要根本改變查詢成本,得做兩件事:改資料模型讓查詢語意能對應到合適的索引型態,建索引讓 PostgreSQL 有索引可走。實作方案:把標籤查詢改成索引友善路徑 我把調校拆成兩步,簡單直接:先改資料型態,再改查詢寫法讓它吃到索引。 A. 資料模型調整(字串 -> 陣列) 先把 'tag1;tag2' 轉為 PostgreSQL 原生 text[],讓查詢語意可以直接映射到陣列運算子: ALTER TABLE customers ADD COLUMN tags_array text[];UPDATE customers SET tags_array = string_to_array(nullif(trim(tags), ''), ';');B. 建立 GIN 倒排索引 CREATE INDEX CONCURRENTLY idx_customers_tags_gin ON customers USING gin (tags_array);查詢改寫為陣列運算(如 &&, @>),讓 PostgreSQL 能走 GIN:tags_array && ARRAY['tag_VIP']::text[]:判斷是否有交集 tags_array @> ARRAY['tag_VIP']::text[]:判斷是否完整包含可帶走的觀念:之後遇到 DB 效能問題都還用得上的基本功 下面這幾個基本功,下次遇到任何資料庫效能問題都會再用到:量測優先於直覺:靠 EXPLAIN ANALYZE 看計畫,永遠比靠經驗或感覺猜瓶頸可靠。 用複雜度語言描述現況:把 N、M、K 這些變數寫出來,才有辦法理性比較不同寫法的代價。 資料模型是性能的天花板:SQL 語法只能在現有結構上做局部優化,要根本拉開差距常常得回頭改欄位設計。 優化要在 plan 上驗證:要看到 Seq Scan 真的換成 Index Scan 才算數,執行時間變短不代表存取路徑改了。結論Regex 的確能先把 CPU 壓力降下來,但資料量一大,真正拉開差距的還是 Array + GIN 這種直接改變查詢路徑的做法。後來,我們選用 Redshift 了! 這篇後記聊聊,為什麼我們最後換了資料庫。 回頭快速複習前兩集:上集:當 LIKE 遇上 Regex 的觀念碰撞 中集:用 EXPLAIN 看見 Seq Scan 的真相
Read More
我們選用 Redshift 了!
上一篇:PostgreSQL 效能優化(下):用 Array + GIN 把標籤變成索引 為什麼從 PostgreSQL 改用 Redshift? 前面三篇聚焦在標籤查詢的調校。正式環境還要做歷史統計,例如比較同一群客戶每月平均餘額的變化,以及不同產品的差異。選型考量 RDS for PostgreSQL(GIN 方案) Redshift歷史資料的統計效率 GIN 可先篩選;命中資料多時,仍要讀取並彙整大量紀錄 欄式儲存與壓縮減少讀取量,並行處理分攤彙整工作每日寫入更新的維護成本 新增資料與更新標籤會增加 GIN 維護及清理工作 省去 GIN 維護,仍有載入、更新與資料整理成本運算資源與費用 費用隨執行個體、IOPS 與儲存配置而變 分析若非全天候,Serverless 隨用隨付可減少閒置運算支出;儲存費另計這批資料每年約 20 TB,正式環境至少要分析兩年、共 40 TB 以上的歷史資料,同時承接每日寫入與更新。 40 TB 本身未超過 RDS for PostgreSQL 的最高儲存規格。我們最後選擇 Redshift,用欄式儲存與並行處理承接大量歷史統計,也不必另外建立與維護 GIN 索引。分析有閒置時段時,Serverless 隨用隨付也能減少運算支出。 Redshift 的 SUPER 陣列 上一篇提出把標籤轉成 PostgreSQL 的 text[] 陣列,再搭配 GIN 索引。換到 Redshift 後,標籤改存進 SUPER;它是可儲存陣列與物件的資料型態,沒有 GIN 的索引功能。 載入時用 SPLIT_TO_ARRAY 把 tag1;tag_VIP 拆成 ["tag1","tag_VIP"],後續就能直接比對完整標籤,不必再拆字串,也避免 LIKE '%tag_VIP%' 連 tag_VIP_plus 一起找到。 CREATE TEMP TABLE customer_tags_demo AS SELECT 1001 AS customer_id, SPLIT_TO_ARRAY('tag1;tag_VIP', ';') AS tags;SELECT DISTINCT c.customer_id FROM customer_tags_demo AS c, c.tags AS tag WHERE tag = 'tag_VIP';c.tags AS tag 會逐個取出陣列裡的標籤,再用 tag = 'tag_VIP' 比對,預期找到客戶 1001。DISTINCT 則讓同一位客戶只出現一次。 資料筆數與每筆標籤越多,展開、比對的工作也越多。 實戰心得:資訊補齊後,重新選型 一開始選 PostgreSQL,是因為我最熟悉它,也能透過 pgvector 擴充套件做向量搜尋。 把正式環境的歷史分析需求、每日寫入更新,以及 AWS 費用一起評估後,團隊最後決定改用 Redshift。 延伸閱讀AWS:Amazon Redshift 與 PostgreSQL 的差異 AWS:Redshift Serverless 隨用隨付計費 AWS:查詢 SUPER 裡的陣列與物件
Read More